Testy píše AI. Ne každé zelené fajfce se dá věřit.
PŘEČÍST ČLÁNEK

AI dnes vygeneruje test za pár sekund. Zelená fajfka u takového testu ale ještě nic nezaručuje. Může znamenat „ověřeno“, ale taky třeba to, že test nic netestuje a prošel naoko. V Etneteře proto stavíme QA Control Center, systém měřící, kolika testům se dá opravdu věřit. Živě jsme ho ukázali na Etnology #6. Tady popisuji, jak funguje a co jsme se cestou naučili.
Vývoj zrychlil. AI pomáhá psát kód, release cykly se zkracují a změn přibývá. Klasické QA s ručně psanými testy a manuální regresí v tomhle tempu dopadne jedním ze dvou špatných způsobů.
Nabízí se nechat psát testy taky AI. Tady ale začíná skutečný problém. Vygenerovaný test, který projde naoko, protože má prázdnou aserci nebo kontroluje špatnou věc, je horší než žádný test. Tváří se jako jistota a není.
Položili jsme si proto jinou otázku. Jak prokázat, že funkce opravdu funguje? A jak poznat, že změna v jedné části nerozbila jinou, o které nikdo neví?
V lednu jsem psal, kam chceme QA s pomocí AI a agentů posunout. Když jsme to začali stavět, byla naše první verze přímočará. Agenti četli zadání, sami procházeli aplikaci v prohlížeči, psali testy a hledali na stránce prvky, na které má test klikat. Výsledky nás rychle vystřízlivily.
Ta skákající čísla mě naučila to nejdůležitější. Pass rate je špatná metrika. Když se stejná funkce jednou „otestuje“ na 76 % a podruhé na 7 %, vypovídá to jen o generátoru testů. O aplikaci se z toho nedozvíte nic.
Druhou generaci jsme proto postavili obráceně. AI rozhoduje tam, kde je potřeba úsudek, tedy u rizik, scénářů a psaní testů. Prohlížeč ovládá deterministický kód. Prvky na stránce změří, takže je model nemusí hádat. A o tom, co se bude testovat, rozhoduje člověk.
Systém začíná tam, kde začíná každý tester, u aplikace a u zadání. Nejdřív si sám zmapuje web. Projde stránky, rozpozná šablony a funkce a sestaví z nich mapu toho, co se dá testovat. U konkrétní funkce pak tester klikne na „Zpracovat“.
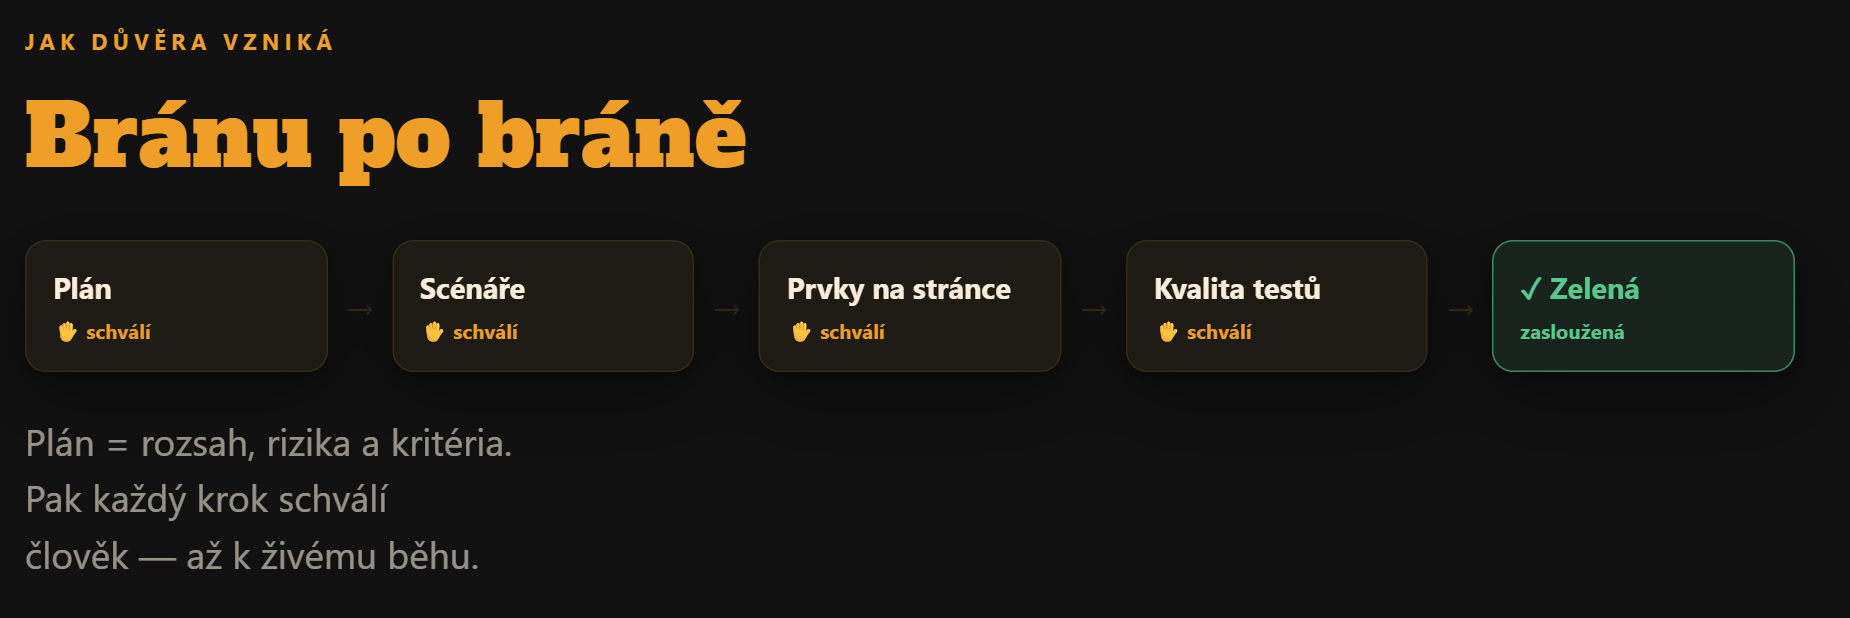
Ze zadání a z JIRA systém navrhne rizika a akceptační kritéria, tedy ověřitelné podmínky nutné pro to, aby funkce fungovala. U každého rizika tester rozhodne, jestli se bude testovat, je mimo rozsah, nebo ho vědomě akceptuje. Z kritérií vzniknou scénáře psané jazykem testera. Prvky na stránce, na které bude test klikat, změří kód a tester je podepíše. Teprve potom vzniknou spustitelné Playwright testy. Projdou statickou kontrolou kvality a poběží proti živé aplikaci.
Každý scénář skončí v jednom ze čtyř stavů.
Tester mezi jednotlivými kroky nemusí sedět u počítače. Na schvalovacím kroku může systém klidně týden čekat a pak pokračuje tam, kde skončil.
Hlavní metrika QA Control Center je podíl scénářů, které skončily v důvěryhodném stavu. Patří mezi ně i FAIL, pokud odhalil skutečnou chybu. Podíl zelených testů mě zajímá málo. Zajímá mě, jestli test říká o aplikaci pravdu.
Co to znamená v praxi? Zpřísnili jsme pravidlo: zelený test, který tvrdí nějakou změnu nebo hodnotu, ale nemá jedinou kontrolu hodnoty, už nepočítáme jako PASS. U jedné z našich testovaných funkcí by tak ze 14 zelených testů vypadlo 5, tedy 36 %.
Pro mě je to přesně ten druh čísla, kvůli kterému systém stavíme. Raději vím, že víc než třetina zelené by byla jen barva, než abych se na ni spoléhal.
Důvěru proto měříme ve dvou osách.
Úvodní číslo aplikace je pak pokrytí × důvěra. Plyne z toho jedno poučení. 100 % PASS neznamená funkci bez chyby. Znamená, že všechny napsané scénáře jsou věrně otestované.
Ověření neplatí navždy. Funkce, která v pondělí prošla, může být ve středu po nasazení změny rozbitá. Pondělní zelená fajfka by pak dál potvrzovala něco, co už neplatí. QA Control Center proto u každé funkce ukazuje, čím je ověřená a od kdy ověření přestalo platit. Rozhodují tři situace.
To poslední je můj vědomý kompromis. Kdybych výhrady v čísle ignoroval, vypadala by funkce lépe, než odpovídá novým pravidlům. Kdybych je počítal jako neověřené, popřel bych důkaz, který existuje. Poloviční váha je řešení, za kterým si dokážu stát před vývojem i před klientem.
QA Control Center jsme vyladili na vlastních funkcích a teď ho chceme nasadit na prvních klientských projektech.
AI dokáže práci v testování obrovsky zrychlit. Pokud ale budeme měřit jen počet zelených testů, budeme rychleji vyrábět falešný pocit jistoty. QA Control Center proto stavíme na jednoduchém rozdělení rolí. AI navrhuje, tester rozhoduje a kód měří. U každé funkce je poctivě zapsané, čím je ověřená a od kdy už ne.
Tohle je první díl série. V dalším se podíváme hlouběji pod kapotu, jak přidělujeme modely šestnácti agentům a proč žádný z nich nesmí do prohlížeče.
Chcete vědět, kolika testům na vašem projektu se dá opravdu věřit? Napište nám a probereme to.